
Zaplatíte si PR výstup v médiích. Uvidí ho ale i modely AI?
Velký přehled českých webů
Shrnutí
- Zkoumali jsme, které weby povolují nebo zakazují přístup LLM nástrojů na svou stránku. To totiž rozhoduje o tom, jestli se tyto výstupy objeví v odpovědích jazykových modelů, a má to přímý dopad na dosah mediálních výstupů i blogů.
- Robots.txt má všech 11 zkoumaných webů, pravidla pro LLM nástroje tedy nikde nechybí. LLMs.txt, tedy mapu obsahu připravenou přímo pro jazykové modely, nemá ani jeden z nich.
- Nejvíc blokovaný je GPTBot společnosti OpenAI, kterému vstup zakazuje pět z 11 webů. S odstupem následuje pětice ClaudeBot, anthropic-ai, Claude-Web, Google-Extended a PerplexityBot, každý z nich blokují tři portály. Naopak nástroje Claude-User a Perplexity-User, které na web přicházejí až na zadání uživatele, a vyhledávací Claude-SearchBot neblokuje ani jeden web.
- Aspoň jeden ze sledovaných nástrojů blokuje pět webů, a to Deník.cz, iDNES.cz, Echo24, Aktuálně.cz a HN.cz. Zbylých šest portálů, mezi nimi Seznam.cz, Novinky.cz i Česká televize, pustí všech dvanáct sledovaných nástrojů.
Důležitost vyhledávání přes AI roste a viditelnost značky v jazykových modelech je klíčová pro komerční úspěch firmy. Proto je důležité, jestli vaše mediální výstupy na webech uvidí i umělá inteligence. Přinášíme velký přehled toho, které LLM nástroje jsou na jednotlivých stránkách blokované nebo povolené.
Navazujeme tím na naši srpnovou analýzu hodnotového nastavení jazykových modelů, ve které jsme na českých tématech sledovali, jak modely odpovídají a nakolik jsou ochotné zaujmout postoj. Tentokrát posouváme stejné téma o krok dál, od otázky, jak jazykové modely odpovídají, k otázce, jestli se do jejich odpovědí vůbec dostane obsah českých médií. Pro komunikaci z toho plyne nový typ rizika. Ne každý zaplacený výstup pomůže tak, jak od něj čekáme. Článek může vyjít na správném médiu, může mít dobrý dosah ve vyhledávání i na sociálních sítích, a přesto zůstane pro jazykové modely neviditelný, protože samotné médium jim vstup zakázalo. Při plánování výstupů a při GEO optimalizaci je proto potřeba dívat se i na to, jak se vydavatel k LLM nástrojům staví.
Seznam sledovaných webů vychází z měření NetMonitor. Do této analýzy jsme vybrali 11 klíčových zpravodajských portálů a 12 LLM nástrojů, tedy stejnou sadu nástrojů jako ve slovenské verzi, aby byly obě země srovnatelné. Výsledky pro dalších 295 českých domén a čtyři nástroje společností ByteDance, Meta, Amazon a Apple máme k dispozici na vyžádání.
To, jestli je daná stránka pro umělou inteligenci přístupná, je dané nastavením souborů robots.txt a llms.txt. Soubor robots.txt specifikuje, které nástroje jsou na webu povolené a které blokované. V případě, že webová stránka tento soubor nemá, jsou povolené všechny nástroje. Soubor llms.txt představuje mapu stránky, která jazykovým modelům pomáhá správně najít určitý obsah a citovat ho ve svých odpovědích.
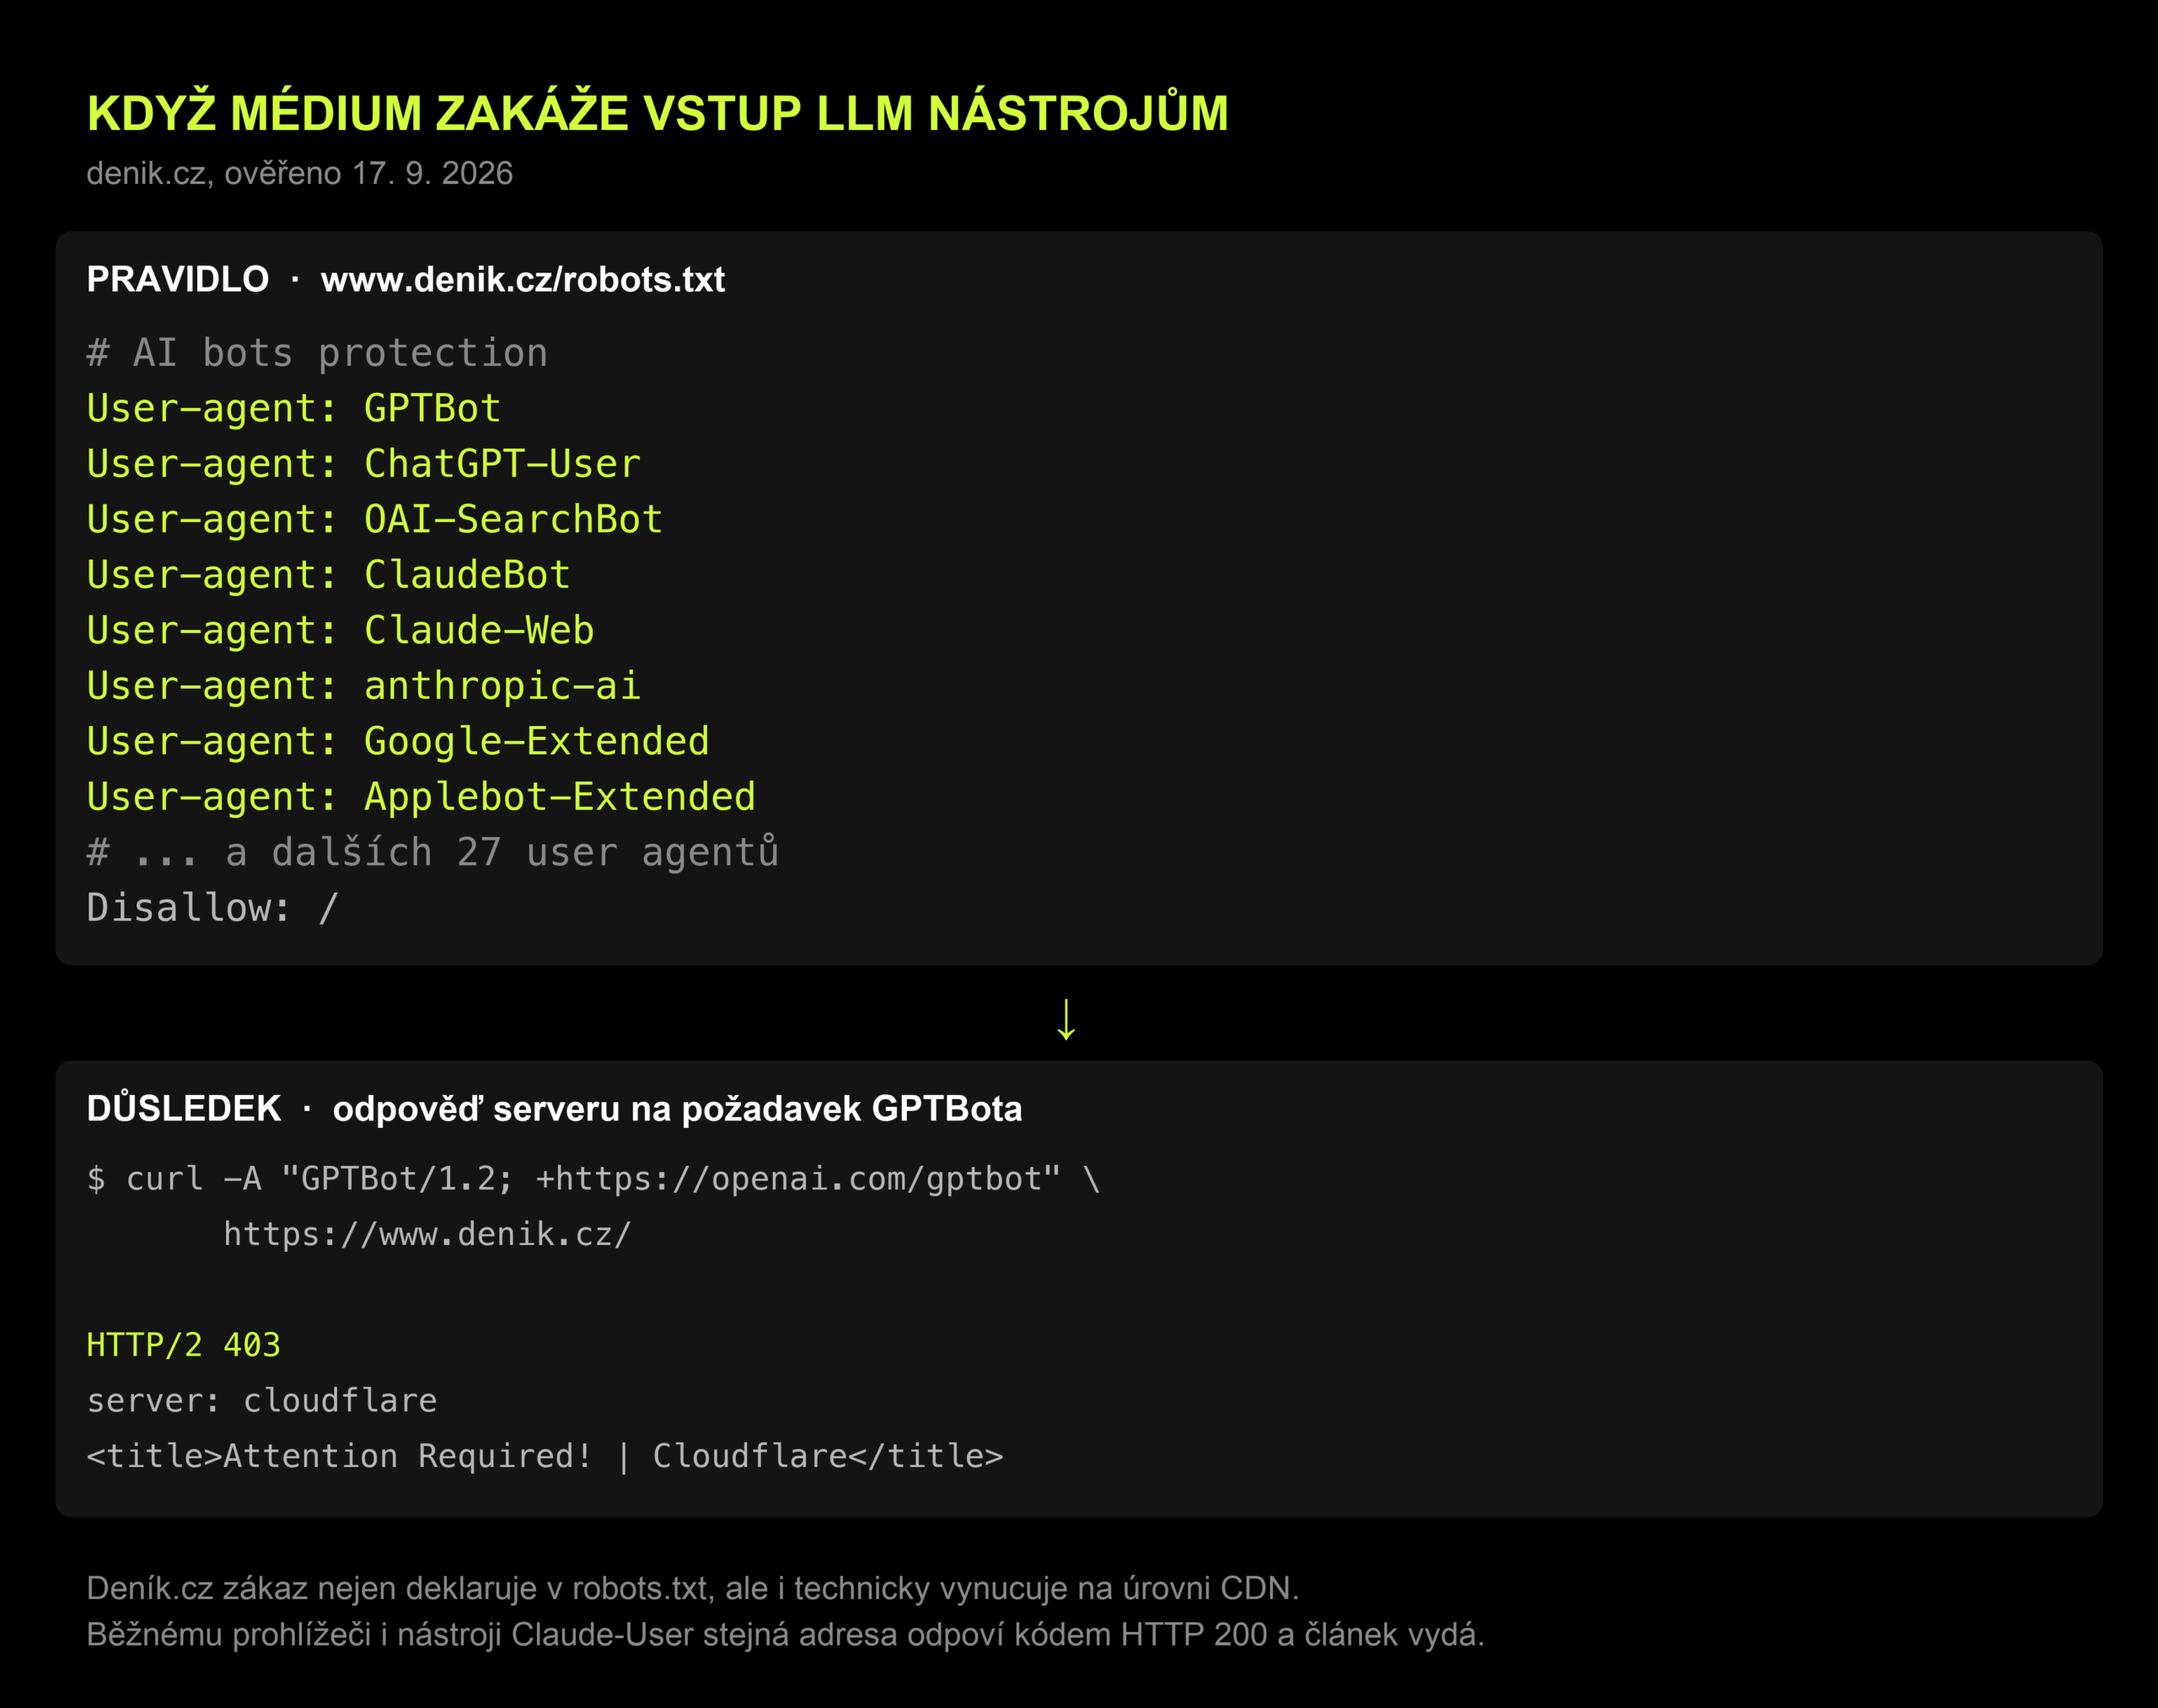
Jak takový zákaz vypadá v praxi, je vidět na Deníku.cz, který má blok napsaný přímo, včetně komentáře, že jde o ochranu před AI boty. V jedné skupině pravidel vyjmenovává 35 user agentů a všem zakazuje celý web.
Kde vaše výstupy uvidí i AI?
Výsledky pro konkrétní web je možné v heatmapě interaktivně filtrovat.
Prvním závěrem měření je, že většina sledovaných webů nechává pro všechny nástroje volný přístup. Dále vidíme, že se weby při selektivním blokování do jisté míry shodují na tom, které nástroje blokovat, a že jsou to skoro výhradně ty tréninkové. Soubor robots.txt nechybí ani jednomu portálu, pravidla má nastavená každý z nich.
Blokující weby a blokované nástroje
Z celkového počtu 11 portálů povoluje všechny nástroje šest webů, konkrétně Seznam.cz, Novinky.cz, Seznam Zprávy, Česká televize, Forum 24 a Český rozhlas. Selektivní blokování některých nástrojů si zvolilo pět webů, a to Deník.cz, iDNES.cz, Echo24, Aktuálně.cz a HN.cz.
Ze zkoumané vzorky 11 webů blokuje aspoň jeden nástroj pět z nich. Nejpřísnější je Deník.cz, který zakazuje devět z 12 sledovaných nástrojů. Druhou příčku sdílí iDNES.cz a Echo24 se shodnými šesti nástroji. Jejich seznamy jsou přitom totožné položku po položce, včetně toho, že je v obou dvakrát zapsaný jeden a tentýž user agent. Oba weby tedy zjevně vycházejí ze stejné šablony. Pořadí uzavírají Aktuálně.cz a HN.cz s jediným blokovaným nástrojem, kterým je v obou případech GPTBot.
Problematika je zajímavá i z pohledu jednotlivých nástrojů. Nejvíc blokovaným je GPTBot společnosti OpenAI, který sbírá obsah pro trénování jejích modelů. Blokování tohoto nástroje má vliv na to, jaké informace se dostanou do tréninkových dat nových modelů, na vyhledávání v ChatGPT ale ne. O tom, jestli se web zobrazí jako zdroj v odpovědích, rozhoduje samostatný OAI-SearchBot, a toho blokuje jediný web. Další příčky patří shodně třem webům u nástrojů ClaudeBot, PerplexityBot a Google-Extended. Google-Extended přitom není nástroj, který by chodil po webech, ani nemá vlastního user agenta, je to přepínač v souboru robots.txt, kterým web určuje, jestli Google smí už prošlý obsah použít na trénování Gemini a na podkládání odpovědí. Na procházení webu ani na pozici v Google Search vliv nemá.
Zajímavý je i opačný konec žebříčku. Claude-User, Perplexity-User a Claude-SearchBot neblokuje ani jeden z 11 webů. České portály tedy pouštějí jak nástroje, které přicházejí až na konkrétní dotaz uživatele, tak jeden ze dvou vyhledávacích nástrojů. Vedle toho stojí za pozornost, že tři weby stále blokují jména anthropic-ai a Claude-Web, která společnost Anthropic v aktuální dokumentaci už neuvádí; aktuální jsou ClaudeBot, Claude-User a Claude-SearchBot. Podobným případem jsou Novinky.cz a Seznam Zprávy, které ve svém robots.txt zakazují vstup user agentovi pojmenovanému prostě AI. Žádný z nástrojů velkých dodavatelů se ale takto nepředstavuje, takže je toto pravidlo v praxi bez účinku. Obojí ukazuje, jak důležitá je průběžná aktualizace souboru robots.txt.
Blokování přitom z pohledu vydavatele není rozmar. Zpravodajský web žije z návštěvnosti a z počtu zobrazených stránek, protože na nich prodává reklamu. Když chatbot převezme obsah článku a uživateli ho shrne přímo v odpovědi, čtenář už nemá důvod na web přijít, a médium tak přichází o návštěvu stránky, tedy o příjem, přestože obsah zaplatila jeho redakce. Zvláštní kapitolou jsou tréninkové nástroje, u kterých médium odevzdá obsah do modelu bez jakéhokoli protiplnění a bez uvedení zdroje. Řada velkých vydavatelství proto přístup blokuje do doby, než se dohodne na licenční smlouvě. Blokování je v tomto světle obranou obchodního modelu, ne nepochopením technologie.
U nástrojů, které přicházejí na zadání uživatele, je potřeba počítat s tím, že zápis v robots.txt nemusí být rozhodující. OpenAI ve své dokumentaci přímo uvádí, že se u akcí vyvolaných uživatelem pravidla robots.txt nemusí uplatnit, protože požadavek nepřichází od crawleru, ale od člověka v chatu. Anthropic to má nastavené jinak a zakázání nástroje Claude-User podle firmy zabrání načtení obsahu v reakci na dotaz uživatele. Pro web z toho plyne, že blokování této skupiny nástrojů je nejméně spolehlivé ze všech a zároveň nejméně výhodné, protože omezuje právě ty návštěvy, které vznikají z konkrétního zájmu lidského uživatele. Pokud je cílem dosah obsahu, dává logiku blokovat tréninkové nástroje a vyhledávací i ty na zadání uživatele nechat projít. Tréninkem vydavatel přichází o obsah bez protiplnění, kdežto citování v odpovědích mu přivádí čtenáře. České portály se zatím chovají přesně takto.
Shrnutí
Experti z marketingu a komunikace už vědí, že pro jejich práci je viditelnost značky v odpovědích umělé inteligence klíčovou novou disciplínou. Odpovědi, které vám chatbot nabízí, ale závisí i na tom, k jakým datům má přístup, a právě proto je dobré vědět, na kterých portálech budou mediální výstupy pro umělou inteligenci neviditelné. Obecným trendem na klíčových českých webech je zatím blokovat přístup LLM nástrojů jen selektivně a mířit hlavně na tréninkové crawlery. Pokud se na problém díváte z hlediska vlastní značky, pak průběžné aktualizace souborů robots.txt a llms.txt patří mezi dobré zvyky z praxe, které vám pomůžou s AI viditelností vaší firmy.
Chcete dostávat naše data a analýzy a být součástí komunity?
